Pakiet dla AI: jak pracować z raportem Wally w ChatGPT, Claude albo Gemini
6 listopada 2026, 7 min czytania
Raport Wally to dziesiątki stron wniosków o kategorii, a pod nimi setki postów, komentarzy i wzmianek w mediach. Czytanie go od deski do deski zajmuje czas. Szybciej jest zapytać o konkret: co mówią klienci konkurencji o zwrotach, która marka najmocniej łamie konwencję, jakich twórców warto sprawdzić. Do tego służy pakiet dla AI.
Pakiet to raport podzielony na kilka plików, które model AI czyta bez zgadywania. Każdy plik mówi, co zawiera i kiedy po niego sięgnąć. Każda sekcja mówi, czy jest faktem, obserwacją czy interpretacją Wally. Surowe dane leżą w tabelach, więc model może je policzyć, zamiast szacować.
Poniżej cała droga na raporcie przykładowym, który dostajesz po założeniu darmowego konta. Z raportem z własnego skanu robisz dokładnie to samo, a jak go ustawić, opisujemy w poradniku Pierwszy skan krok po kroku.
Krok 1. Otwórz raport
Zaloguj się i wejdź w Projekty. Kliknij skan, z którym chcesz pracować. Na nowym koncie jest tu projekt przykładowy Answear (DEMO), pełny raport kategorii modowych marketplace’ów.
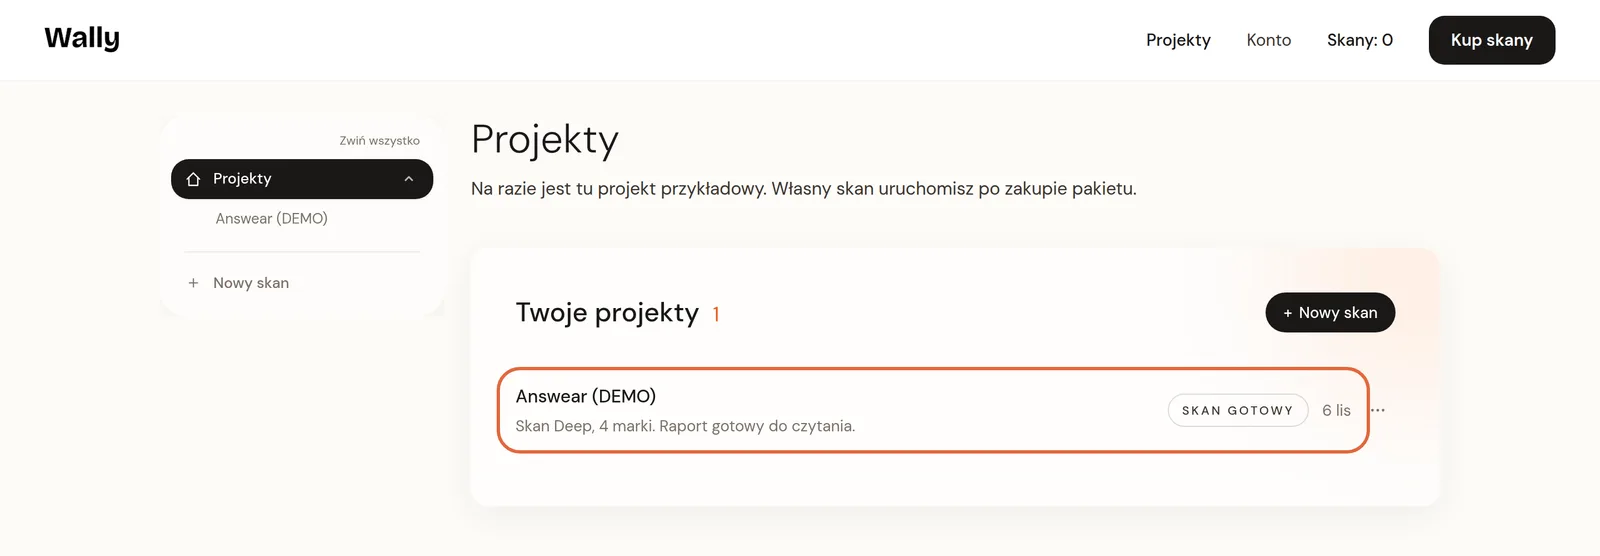
Nie masz jeszcze konta? Załóż darmowe konto, a raport przykładowy otworzy się zaraz po potwierdzeniu emaila. Nie potrzebujesz karty ani danych firmy.
Krok 2. Pobierz pakiet dla AI
W lewej kolumnie raportu, pod nazwą marki, są przyciski do pobierania. Kliknij Pakiet dla AI (.zip). Po kilku sekundach przeglądarka zapisze plik o nazwie podobnej do wally-answear-2026-06-01.zip: marka i data raportu.
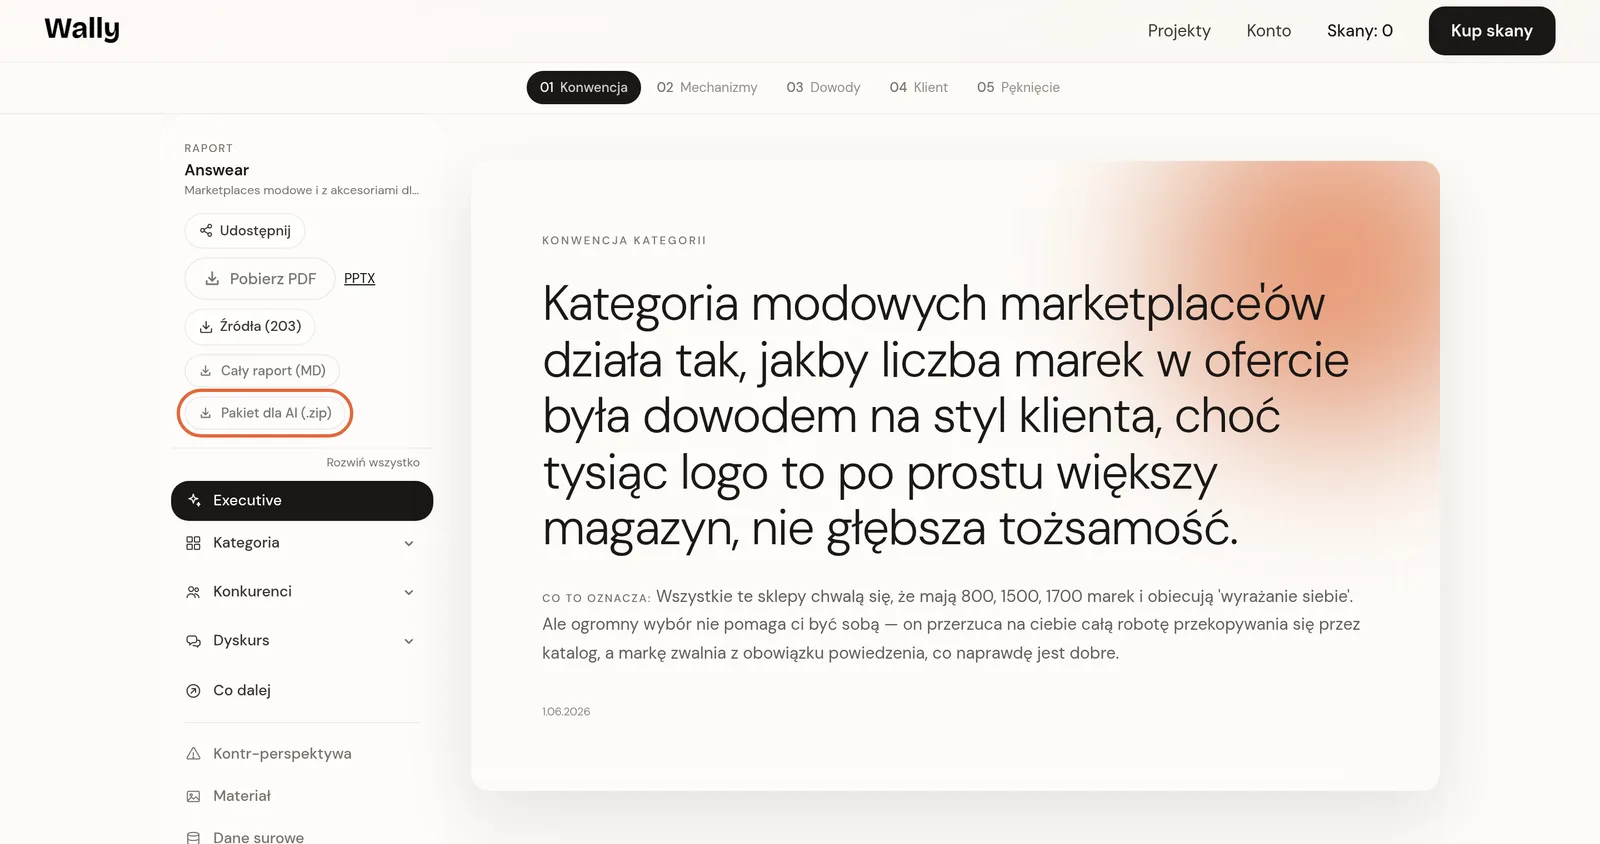
Obok są jeszcze PDF, PPTX, lista źródeł i cały raport w jednym pliku Markdown. Pakiet dla AI różni się od nich tym, że jest podzielony na części i opisany dla modelu. Jeden wielki plik model czyta gorzej: gubi się w środku i miesza wnioski z danymi.
Krok 3. Rozpakuj plik
Kliknij pobrany plik dwa razy, a system rozpakuje go do folderu. Nie wszystkie czaty czytają archiwa .zip, dlatego do modelu wgrywasz pliki z folderu, nie samo archiwum.
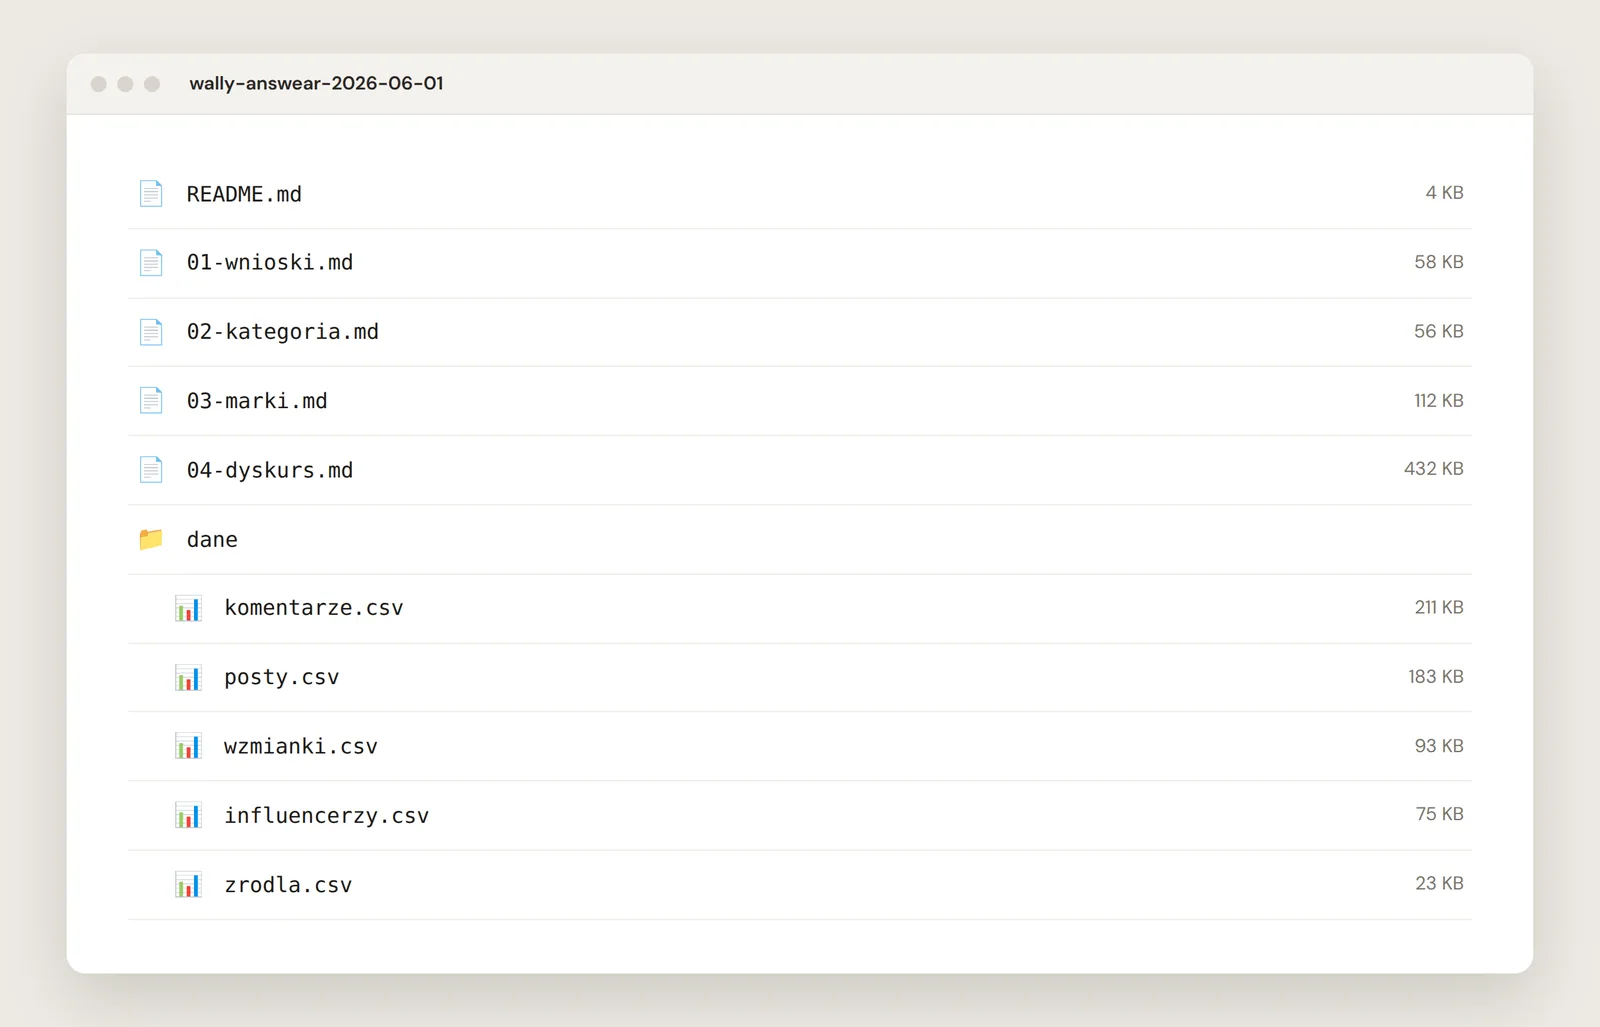
W folderze są trzy rodzaje plików:
README.md: spis treści pakietu i zasady dla modelu. Od niego model zaczyna.01-wnioski.md,02-kategoria.md,03-marki.md,04-dyskurs.md: treść raportu, ułożona tak jak zakładki w Wally.- Folder
dane: tabele CSV z każdym zebranym komentarzem, postem, wzmianką w mediach, postem twórcy i cytatem ze stron marek.
Co jest w środku
README.md: mapa dla modelu
Na górze jest metryka raportu: marka klienta, kategoria, analizowane marki i okres danych. Pod nią tabela plików. Przy każdym pliku jest jego zawartość, przybliżona liczba tokenów i podpowiedź, kiedy po niego sięgać. Dzięki temu model nie musi czytać wszystkiego, żeby odpowiedzieć na pytanie o jedną markę.
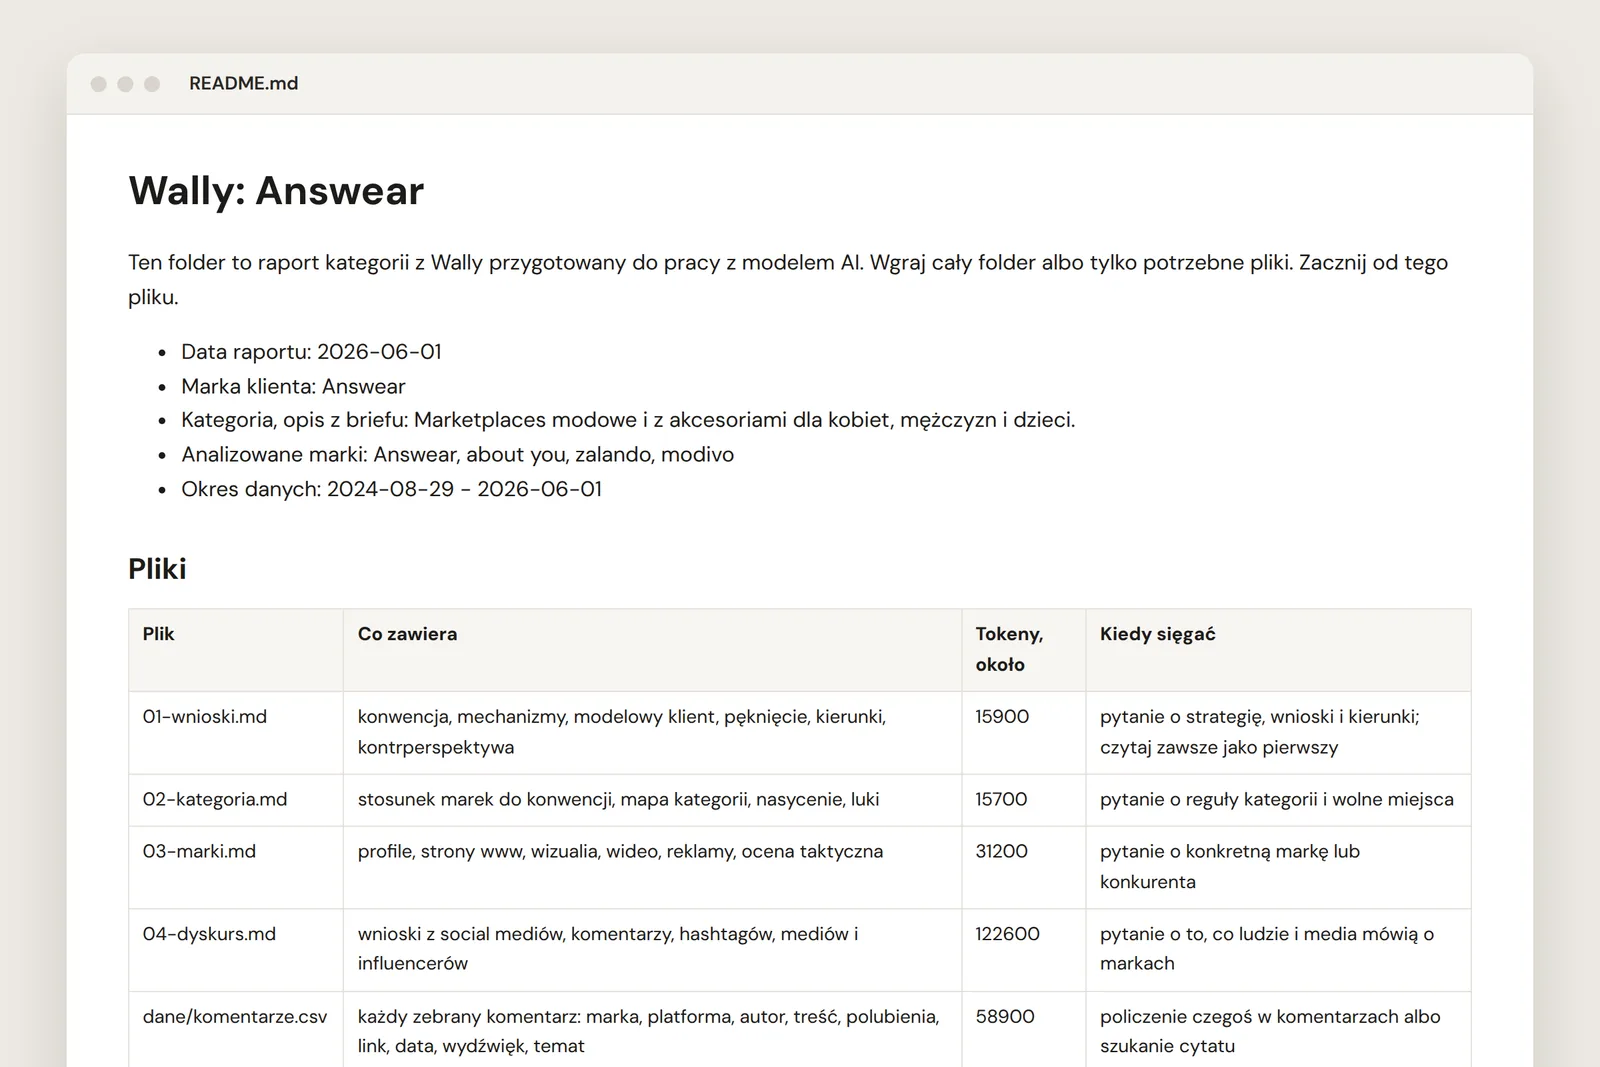
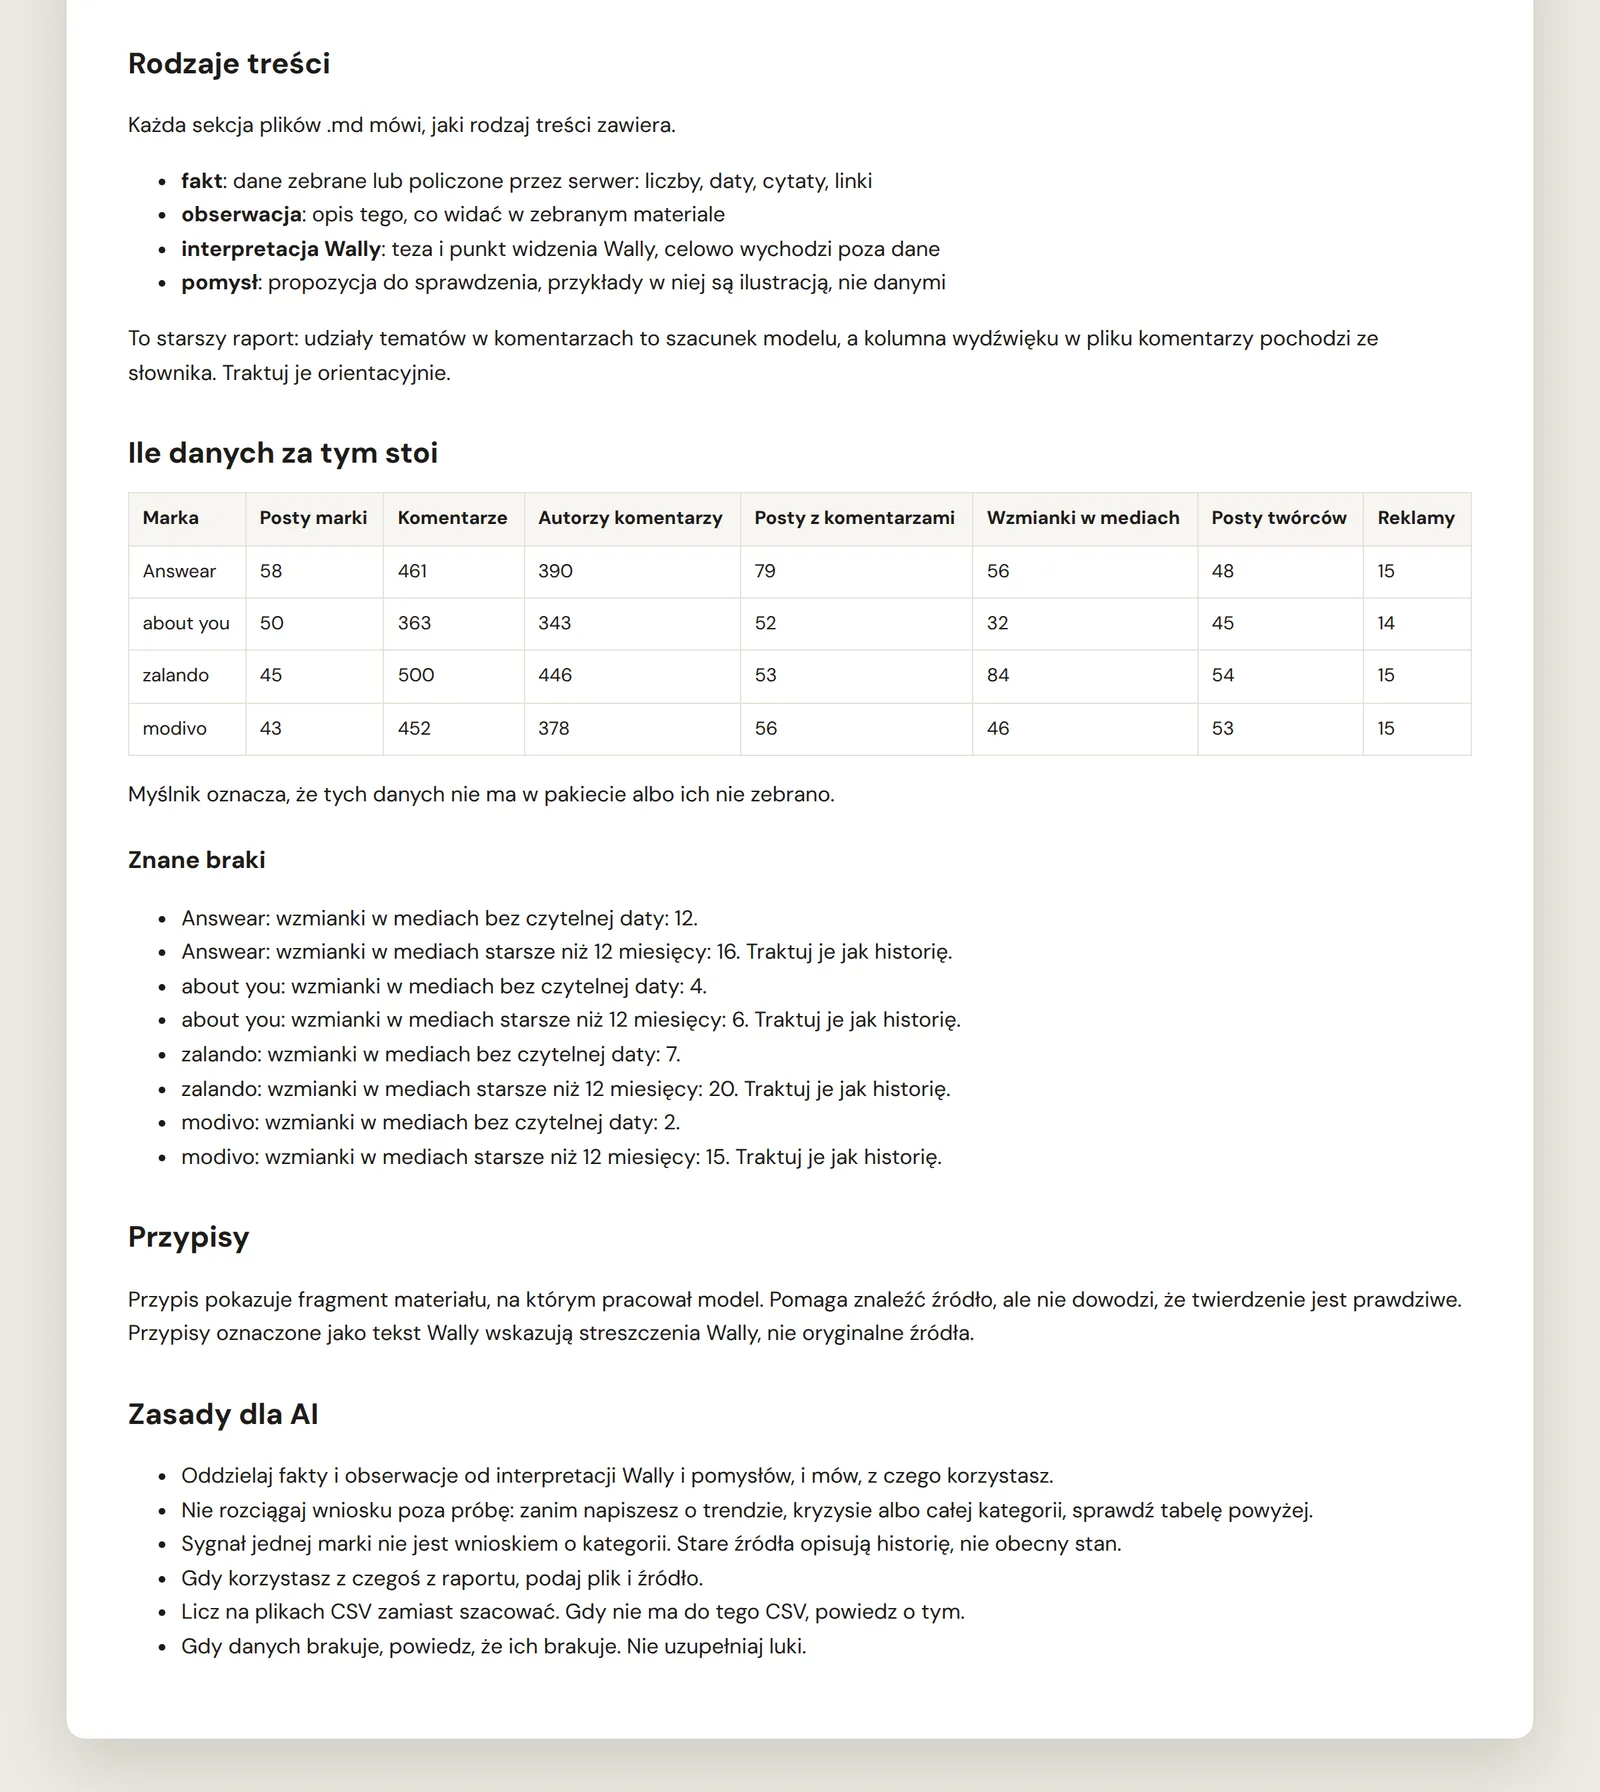
Niżej są cztery rzeczy, które chronią przed zmyślaniem. Rodzaje treści tłumaczą etykiety sekcji. Ile danych za tym stoi pokazuje, z ilu postów, komentarzy i wzmianek powstał raport dla każdej marki. Znane braki mówią, czego nie zebraliśmy albo co jest stare. Zasady dla AI każą modelowi oddzielać fakty od interpretacji, liczyć na tabelach i przyznawać się do braku danych.
Pliki z wnioskami: treść raportu z etykietami
Każdy plik .md zaczyna się krótkim opisem: z jakiego raportu pochodzi, jakie rodzaje treści zawiera, ile danych za nim stoi i kiedy go czytać. Pod opisem jest treść zakładek raportu. Każda sekcja ma etykietę rodzaju treści, na przykład „interpretacja Wally” przy konwencji kategorii albo „fakt, obserwacja” przy liczbach z social mediów.
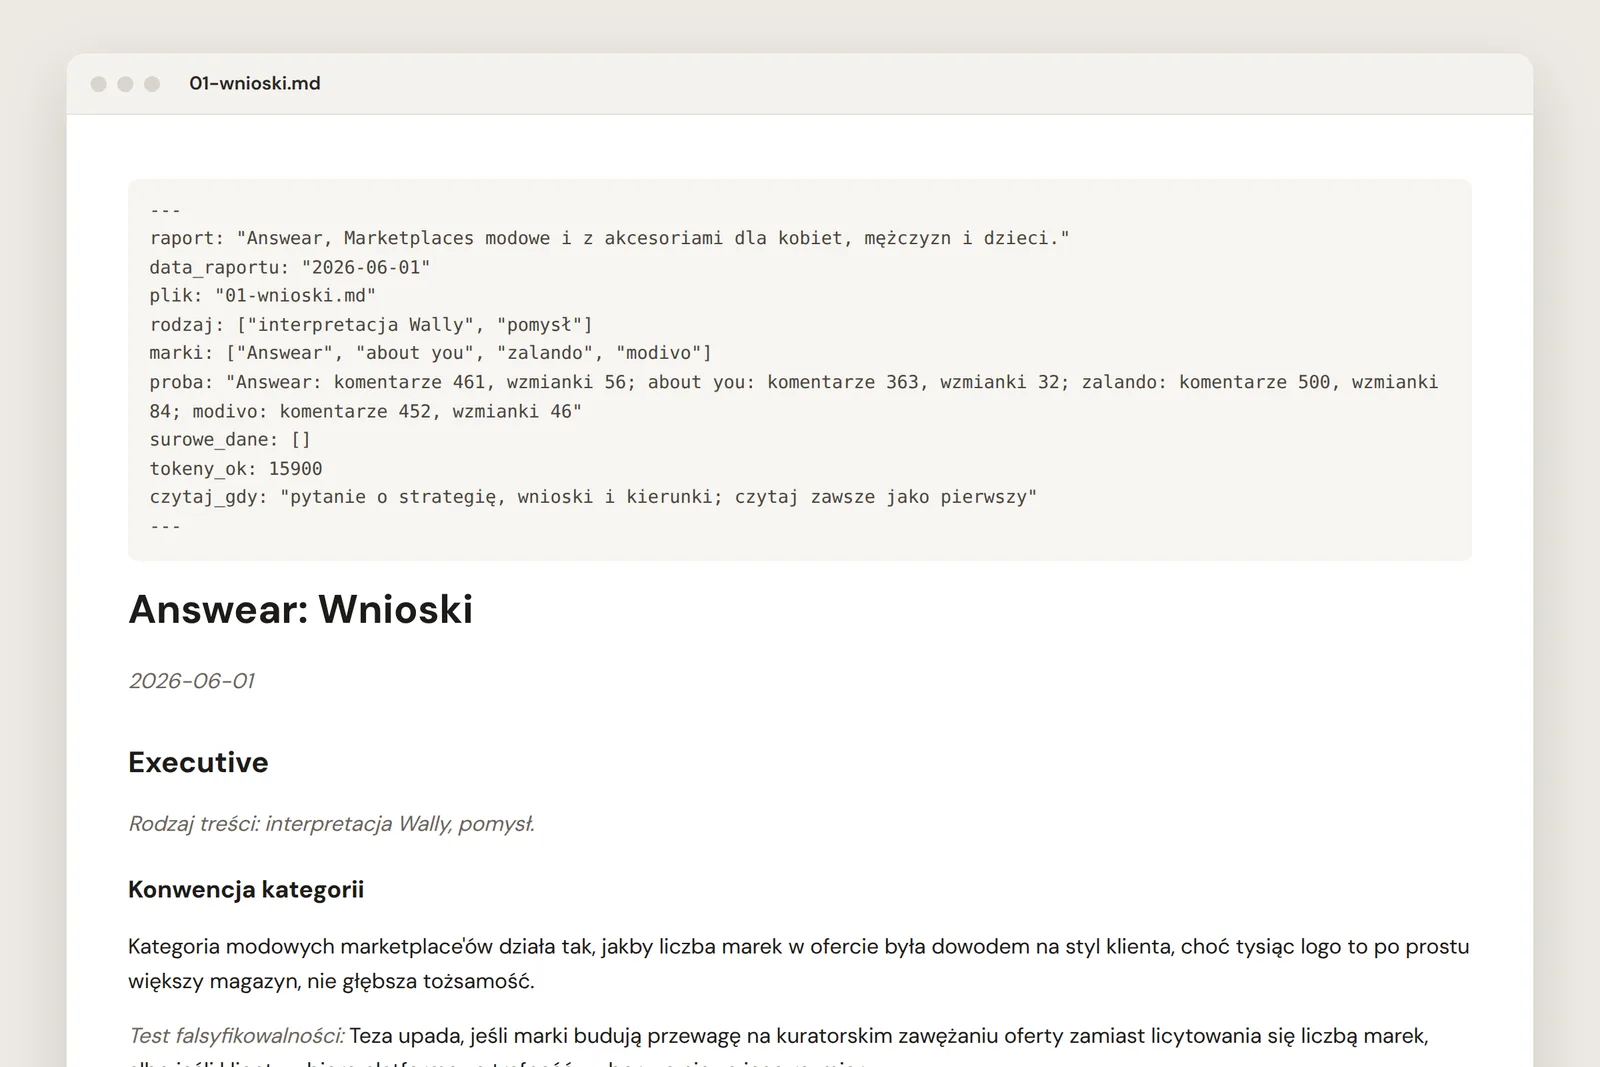
Etykiety są ważne, bo Wally celowo ma własne zdanie. Konwencja, pęknięcie i kierunki to teza do przemyślenia, nie wynik pomiaru. Model, który to wie, nie poda Ci interpretacji jako faktu. Skąd te części raportu się biorą, opisujemy w przewodniku Jak czytać raport Wally w 15 minut.
Tabele z danymi: do liczenia i szukania cytatów
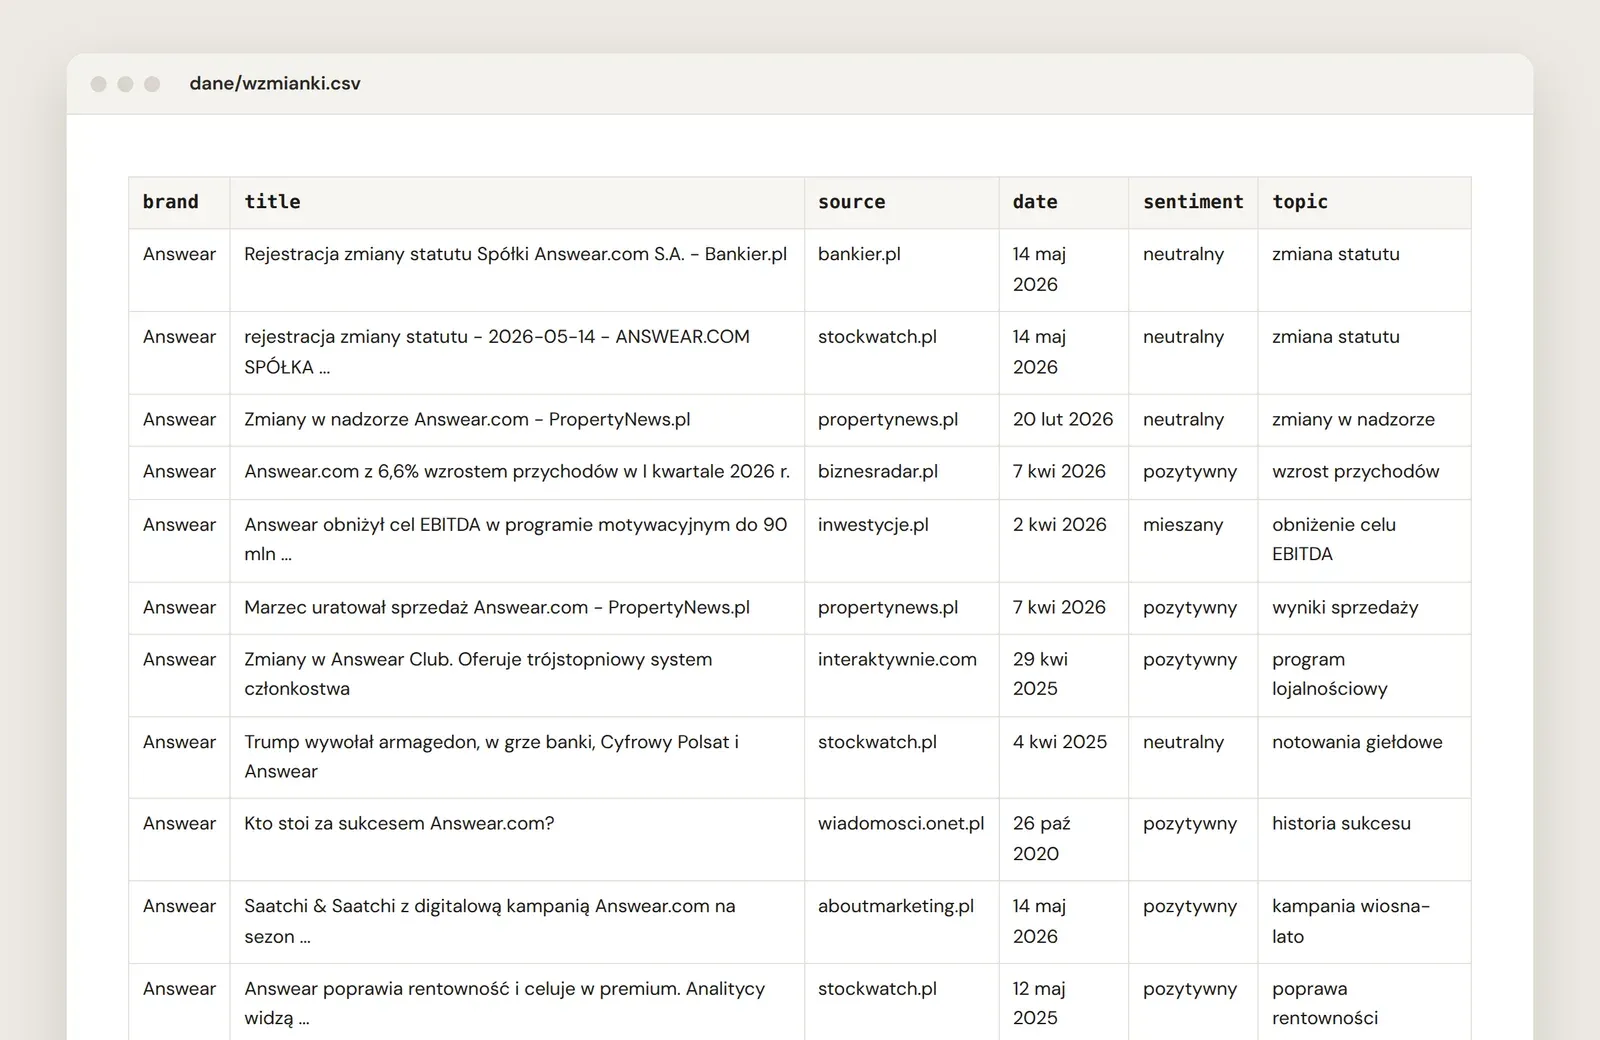
W folderze dane każdy wiersz to jeden komentarz, post, wzmianka albo post twórcy, z linkiem do źródła i datą. Na tych tabelach model liczy: ile negatywnych wzmianek miała marka w ostatnim kwartale, który post zebrał najwięcej komentarzy, którzy twórcy oznaczali konkurencję.
Krok 4. Wgraj pliki do modelu
Pakiet działa w każdym czacie, który przyjmuje pliki: ChatGPT, Claude, Gemini czy NotebookLM. Najwygodniej pracuje się w projekcie (w ChatGPT i Claude to funkcja Projekty). Pliki wgrywasz raz, a potem zadajesz pytania w wielu rozmowach.
- Zacznij od
README.mdi01-wnioski.md. To wystarczy do pytań o strategię i kierunki. - Dokładaj resztę według pytania. Pytasz o konkurenta, dodaj
03-marki.md. Pytasz o głos klientów, dodaj04-dyskurs.mdidane/komentarze.csv. - Gdy model ma pracować na całym raporcie, wgraj cały folder do projektu. Największy jest plik o dyskursie, bo zawiera opisy komentarzy i wzmianek. Jeśli czat nie przyjmie wszystkiego naraz, wgraj najpierw README i pliki potrzebne do pytania.
Krok 5. Zadawaj konkretne pytania
Najlepsze odpowiedzi dają pytania, które mówią modelowi, z którego pliku korzystać i w jakiej formie oddać wynik. Kilka sprawdzonych przykładów do skopiowania:
Na start: szybkie streszczenie z rozróżnieniem faktów i tez.
Przeczytaj README.md i 01-wnioski.md. Streść w pięciu zdaniach konwencję kategorii i pęknięcie. Przy każdym zdaniu napisz, czy to fakt, obserwacja czy interpretacja Wally.
Liczenie na tabeli zamiast szacowania.
Na podstawie dane/komentarze.csv policz dla każdej marki, ile komentarzy dotyczy zwrotów, reklamacji albo dostawy. Pokaż wynik w tabeli i podaj po trzy dosłowne cytaty z linkami.
Szybki przegląd mediów jednej marki.
Z dane/wzmianki.csv wypisz wzmianki o zalando z ostatnich sześciu miesięcy, które mają wydźwięk negatywny albo mieszany. Dla każdej podaj źródło, datę i jedno zdanie, o co chodzi.
Praca kreatywna oparta na głosie klientów.
Zaproponuj trzy kierunki komunikacji dla Answear, które łamią konwencję opisaną w 01-wnioski.md. Każdy kierunek uzasadnij jednym cytatem z dane/komentarze.csv i podaj link do komentarza.
Dobór twórców do sprawdzenia.
W dane/influencerzy.csv znajdź pięciu twórców, którzy oznaczali konkurencję, ale nie Answear. Posortuj ich według liczby obserwujących i zaznacz, przy których postach są sygnały płatnej współpracy.
Trzy nawyki, które chronią przed błędami
- Proś o źródło. Każ modelowi podawać plik i link przy każdym twierdzeniu. Przypis nie dowodzi, że zdanie jest prawdziwe, ale pozwala to sprawdzić w kilka sekund.
- Patrz na próbę. Zanim powiesz klientowi o trendzie albo kryzysie, sprawdź w README, z ilu komentarzy i wzmianek powstał wniosek. Sygnał jednej marki to jeszcze nie prawda o całej kategorii.
- Oddzielaj tezę od danych. Interpretacja Wally jest punktem wyjścia do rozmowy, nie wynikiem badania. Model z pakietem to rozróżnia, więc pytaj go wprost, na czym opiera odpowiedź.
Pakiet z raportu przykładowego możesz pobrać od razu po założeniu darmowego konta.
Załóż konto i zobacz raport